Профиль: Аноним (вход | регистрация) неRU opennet.me  
OpenNET

[ новости /+++ | форум | теги |    ]

Qwenputer - редакция AI-модели Qwen3.5, способная симулировать RISC-V CPU для выполнения кода на C и MicroPython

29.10.2026 09:51 (MSK)

В рамках проекта Qwenputer исследователи подготовили расширенный вариант AI-модели Qwen3.5-4B, в котором реализован встроенный симулятор полноценного 32-разрядного CPU на базе архитектуры RISC-V (RV32IM), поддерживающего расширение Zba и оснащённого сопроцессором bignum для арифметических операций с большими числами. Реализация ядра CPU скомпилирована в набор весов и интегрирована в большую языковую модель в виде 11 дополнительных слоёв трансформеров, добавленных перед основными слоями Qwen. Вычисления выполняются непосредственно в процессе прямого прохода (forward pass) нейросети, без подключения внешних инструментов или плагинов.

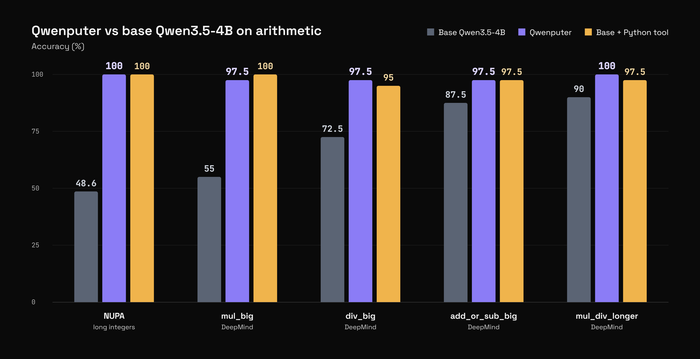
Реализация успешно проходит все проверки из официального набора тестов riscv-tests и способна выполнять скомпилированный код на C и MicroPython. При выполнении арифметических вычислений с большими числами Qwenputer обеспечивает точность 97.5-100%, что сопоставимо или превосходит результаты базовой модели Qwen3.5 с подключённым внешним интерпретатором Python.
Для симуляции оперативной памяти в модели задействованы отдельные слои Gated DeltaNet (линейные RNN), применяемые в штатной AI-модели Qwen для сохранения изменённого состояния при работе с большими контекстными окнами. Путём фиксации состояния гейта и применения унитарного кодирования (one-hot) каждый запрос на запись перезаписывает ровно одну строку матрицы состояния, что позволяет использовать состояние DeltaNet как адресуемую память фиксированного размера, избегая линейного роста KV-кэша (Key-Value) при увеличении длины контекста. В подобной памяти размещаются регистры CPU, данные и выполняемый машинный код.
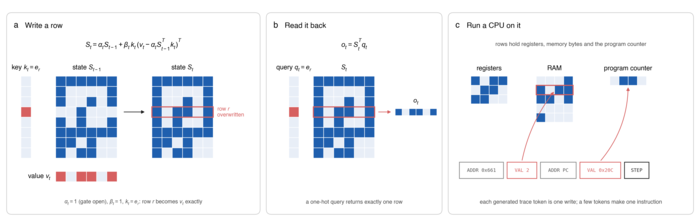
Инструкции процессора, такие как чтение регистров, арифметические операции и условные переходы, компилируются непосредственно в веса слоёв трансформера. С каждой инструкцией сопоставляются специальные токены (ADDR, VAL, STEP), которые слои AI-модели интерпретируют как логику работы CPU. Для инициализации CPU и загрузки прошивки применяется небольшой внешний драйвер RvChat, но сам машинный код обрабатывается полностью внутри весов модели.

Из ограничений проекта упоминается примерно двухкратное по сравнению с исходной моделью Qwen увеличение размера (18.8 ГБ) при сохранении срезов состояния (checkpoint), возникающее в основном из-за добавочного заполнения дополнительных слоёв. Также отмечается относительно низкая скорость вычислений (порядка 3200 токенов в секунду на GPU L4), из-за чего сложные расчёты могут занимать секунды, а не миллисекунды.

Дополнительно реализован вариант AI-модели с экспериментальной файловой системой, позволяющей хранить внутри весов AI-модели до 512 файлов с 53 тысячами токенов текста. Как и в реализации оперативной памяти хранение организовано в привязке к состояниям DeltaNet, но отличается тем, что ФС обеспечивает постоянное хранение, не теряющее состояние между сеансами.

Наработки Qwenputer также легли в основу исследования новых потенциальных проблем с безопасностью в AI. На примере Qwenputer показано как специально модифицированная AI-модель может скрывать свои рассуждения в RNN-состоянии и обходить механизмы мониторинга рассуждений модели (CoT, Chain-of-Thought). Также продемонстрирована возможность создания механизмов контроля и мониторинга безопасности, встроенных в веса AI-модели, которые сама модель не может отключить или изменить.

  1. Главная ссылка к новости (https://news.ycombinator.com/i...)
  2. OpenNews: Проект PyXL развивает процессор для выполнения байт-кода Python
  3. OpenNews: Проект по производству открытого процессора, совместимого с Z80
  4. OpenNews: Представлен RV64X, открытый GPU на базе технологий RISC-V
  5. OpenNews: Открытый GPU Nyuzi задействован для научных исследований
  6. OpenNews: Опубликован Vortex 3.0, открытый GPGPU на базе архитектуры RISC-V
Лицензия: CC BY 3.0
Короткая ссылка: https://opennet.ru/66569-ai
Ключевые слова: ai, cpu, riscv
При перепечатке указание ссылки на opennet.ru обязательно


Обсуждение (14) Ajax | 1 уровень | Линейный | +/- | Раскрыть всё | RSS
  • 1.1, Аноним (1), 10:21, 29/10/2026 [ответить] [﹢﹢﹢] [ · · · ]  
  • +2 +/–
    Блин, а нафига? Почему нельзя снабдить АИ-агента отдельной не-нейросетевой библиотекой, которая и будет выполнять код?
    Ну то есть - если АИ нужен отдельный калькулятор, почему её просто не снабдить им?
     
     
  • 2.4, похнапоха (?), 10:35, 29/10/2026 [^] [^^] [^^^] [ответить]  
  • +1 +/–
    Так и делают, любой фреймворк хоть нативный от вендоры, так и langchain/langgraph снабжают интсртументами, и ИИ модель использует доступные инструмены по необходимости в рамках (и не только) в парадигмы ReAct. А тут господа намутили какой-то треш, еще и размер огромный!
     
     
  • 3.13, Аноним (13), 11:58, 29/10/2026 [^] [^^] [^^^] [ответить]  
  • +/–
    Я думаю тут задача на будущее, где не останется детерминированного софта, будут только нейросети разных квантований на нейрочипах NPU. Им нужно будет писать софт для себя самих же и выполнять легаси. Все идёт к полному исчезновению программистов и даже архитекторов. Останутся только аналитики и их документация.
     
  • 2.7, Аноним10084 и 1008465039 (?), 11:02, 29/10/2026 [^] [^^] [^^^] [ответить]  
  • +3 +/–
    Так не модно. Ты что предлагаешь, считать обычным калькулятором? Это скучно и старомодно, в этом ни грамма ИИ! А вот если модель сама считает - то уже класс, чувствуется вкус ИИ
     

  • 1.5, Аноним (5), 10:38, 29/10/2026 [ответить] [﹢﹢﹢] [ · · · ]  
  • +/–
    >Реализация ядра CPU скомпилирована в набор весов и интегрирована в большую языковую модель в виде 11 дополнительных слоёв трансформеров

    Даже реализация на Python получилось бы производительнее и экономичнее к ресурсам.


  • 2.9, Аноним (9), 11:09, 29/10/2026 [^] [^^] [^^^] [ответить]  
  • +2 +/–
    так ты ничего не продашь...
     

  • 1.8, Аноним (8), 11:06, 29/10/2026 [ответить] [﹢﹢﹢] [ · · · ]  
  • +1 +/–
    Даже с локальной qwen надо быть осторожнее:
    - https://3dnews.ru/1150478/
    - https://www.theregister.com/ai-and-ml/2026/10/26/alibabas-qwen-ai-caught-tryin
     
  • 1.10, Аноним (10), 11:18, 29/10/2026 [ответить] [﹢﹢﹢] [ · · · ]  
  • +1 +/–
    >в виде 11 дополнительных слоёв трансформеров, добавленных перед основными слоями Qwen
    >двухкратное по сравнению с исходной моделью Qwen увеличение размера (18.8 ГБ)

    с одной стороны, крайне расточительно

    с другой стороны, у нас есть коннектомы как в prey (ну почти) и способ их формирования (из terse спеки получить пусть и по размеру вторую копию qwen 4b, но абсолютно нативную репрезентацию доменноспецифичного мозга-процессора). Т.е. на какой-нибудь серверной gpu можно будет перемолотить мозг мухи (идеальный целеуказатель с околонулевым latency) в llm.

     
  • 1.11, Метрика (?), 11:32, 29/10/2026 [ответить] [﹢﹢﹢] [ · · · ]  
  • +/–
    Эмулятор инструкций процесса написали которых и так десятки существуют, спрашивается зачем?
     
  • 1.12, Аноним (12), 11:47, 29/10/2026 [ответить] [﹢﹢﹢] [ · · · ]  
  • +/–
    Присоединюсь к выше отписавшимся - в чем смысл? Суть нейронных сетей в вычислениях, которые алгоритмически трудно реализовать. Или неизвестно ка реализовать. В общем, где алгоритм напрямую не написать, но требуемый результат известен, исходя из которого можно натренировать сетку его выдавать. В данном случае никакой алгоритмической сложности эмуляция процессора не представляет, по крайней мере такой, чтобы для этого требовалась нейронка.

    Второе - ну это же тупо деградация нейросетки до FPGA. Только веса затупить до бинарных 0/1.


  • 2.15, Loki13 (ok), 12:05, 29/10/2026 [^] [^^] [^^^] [ответить]  
  • +/–
    Может быть так имеет смысл делать чтобы в будущем нейросетки могли сами разрабатывать новые процессоры? Ну это предположение где это может быть полезно.
     

  • 1.14, Аноним (14), 12:05, 29/10/2026 [ответить] [﹢﹢﹢] [ · · · ]  
  • +/–
    Технически это своего рода pure python реализация какой-нибудь тяжелой функции, когда рядом лежат куча готовых, отлаженных и быстрых нативных расширений. Оно конечно не очень или совсем не нужно прямо сейчас, но направление эмуляции каких-то систем с иными подходами для расчета думаю будет расширяться. Также как возможность хранить в контексте информацию с какой-то гарантией на точность (аля ECC). Дальше получается возможность иметь в рассуждениях цепочки с формальной верификацией. На первых порах конечно это всё будет работать очень не оптимально и требовать большую избыточность по ресурсам. Но рано или поздно всё это тоже выстрелит.
     
  • 1.16, Аноним (16), 12:06, 29/10/2026 [ответить] [﹢﹢﹢] [ · · · ]  
  • +/–
    > Блин, а нафига?
    > Присоединюсь к выше отписавшимся - в чем смысл?

    Первая ссылка в статье
    Qwenputer is a pretty fun experimental model.

    Еще больше смысла дает чтение новости до конца.


  • 2.17, Аноним (17), 12:19, 29/10/2026 [^] [^^] [^^^] [ответить]  
  • +/–
    как будто к поезду приделывают деревянные колеса, никакого сакрального смысла.
     

     Добавить комментарий
    Имя:
    E-Mail:
    Текст:


    XSQUARE
    Inferno Solutions
    Hosting by Hoster.ru
    Хоcтинг: